
Automatiser les documents PDF et XML pour gagner du temps
Sommaire
Produire un document PDF à partir de données actualisées paraît simple tant que le volume reste limité. Dès qu’il faut générer plusieurs centaines de notices, catalogues, fiches techniques ou formulaires, les manipulations manuelles deviennent longues et les erreurs se multiplient. L’automatisation documentaire PDF et XML répond à ce besoin en séparant les données, la structure et la mise en page, tout en ouvrant la réflexion vers une organisation plus large des flux de production.
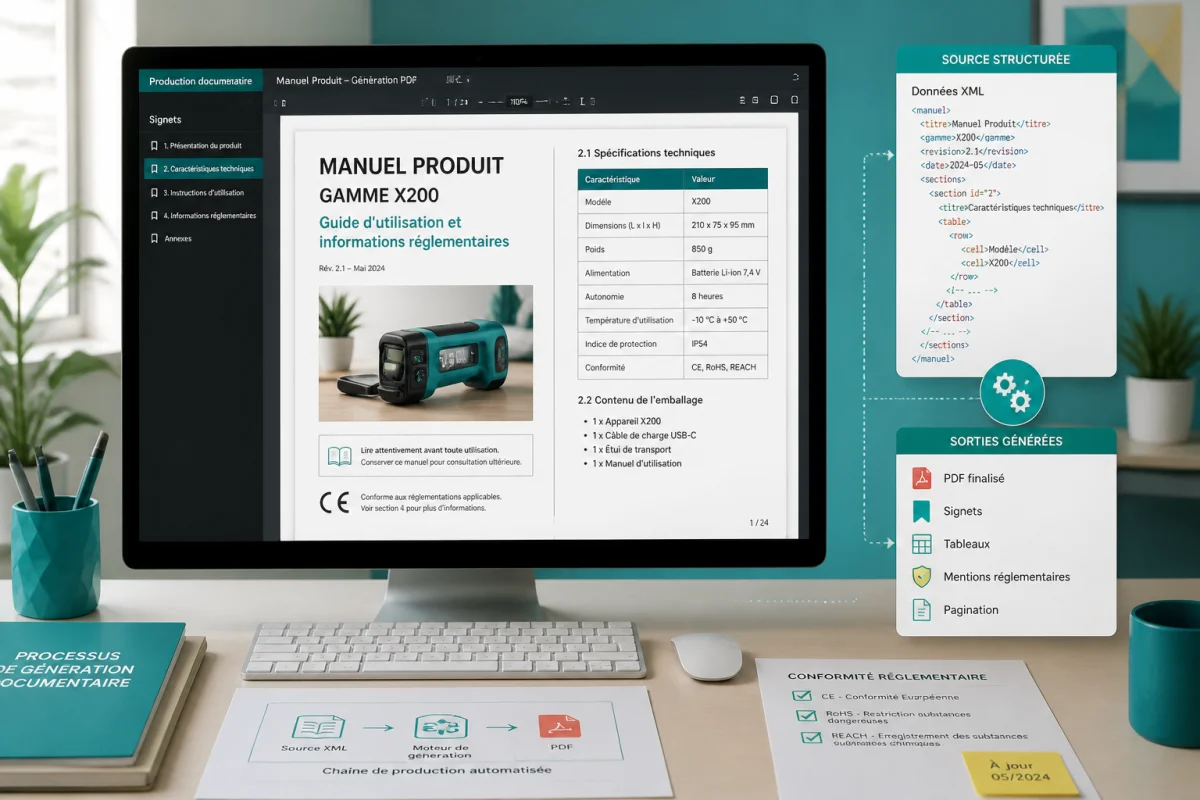
Le principe consiste à conserver les informations dans une source structurée, souvent en XML ou dans une base de données, puis à appliquer des règles de transformation pour produire un PDF homogène. Une modification effectuée dans la donnée source peut ainsi être répercutée dans plusieurs documents et plusieurs formats. Cette approche dépasse la simple génération de fichiers, car elle permet de concevoir un processus reproductible pour créer, mettre à jour, contrôler et diffuser des contenus techniques à grande échelle.
Cette logique rejoint directement les méthodes dédiées à l’automatisation de la production documentaire. L’objectif est de structurer chaque étape afin que la production reste rapide, cohérente et facilement maintenable lorsque le volume augmente. Pour approfondir cette démarche, l’article consacré à l’automatisation de la production documentaire avec méthode apporte un angle utile sur l’organisation des flux et le choix des outils.
Comprendre le rôle de chaque format
PDF et XML ne remplissent pas la même fonction. Le XML décrit le contenu et sa structure, tandis que le PDF restitue une mise en page destinée à la lecture, à l’impression ou au partage. Cette distinction est la base d’une automatisation solide.
Le XML comme source structurée
Un fichier XML peut contenir un titre, une référence produit, une description, des caractéristiques, des avertissements et des données de version dans des balises clairement définies. Les éléments sont identifiables par une machine, ce qui facilite leur réutilisation dans une fiche PDF, une page web, un catalogue ou une documentation électronique.
Pour obtenir un résultat fiable, le modèle XML doit être conçu avant les gabarits graphiques. Il faut définir les champs obligatoires, les formats attendus, les valeurs autorisées et les relations entre les éléments. Par exemple, une référence produit ne devrait pas être saisie tantôt avec des espaces, tantôt sans séparateur, si elle sert ensuite à nommer les fichiers ou à générer un index.
Le PDF comme format de restitution
Le PDF intervient au dernier stade pour présenter les informations dans une forme stable. Il peut intégrer une couverture, une pagination, des tableaux, des images, des signets et des mentions réglementaires. Le document final doit cependant être traité comme le résultat d’un processus, et non comme le fichier maître à modifier manuellement.
Cette séparation évite de corriger une information à plusieurs endroits. Si le poids d’un produit change, la donnée est mise à jour dans la source, puis les sorties concernées sont régénérées. La mise en page reste pilotée par des règles, ce qui limite les écarts entre les éditions.
Construire un flux d’automatisation fiable
Une automatisation documentaire efficace commence par la cartographie du flux existant. Il faut identifier l’origine des données, les personnes qui les valident, les règles de mise en page, les formats attendus et les canaux de diffusion. Cette étape révèle souvent que le principal ralentissement ne se trouve pas dans la génération du PDF, mais dans la préparation ou la validation des informations.
1. Centraliser les données utiles
La première action consiste à désigner une source de référence. Il peut s’agir d’un système de gestion de contenu, d’une base produit, d’un fichier XML validé ou d’une combinaison de ces éléments. Une source unique réduit les divergences entre documents et facilite la recherche d’une information à jour.
Dans un cas pratique, une entreprise qui publie 1 000 fiches produits peut stocker les données communes une seule fois, puis associer chaque fiche à un gabarit. Une évolution de la charte graphique ne nécessite alors pas une reprise manuelle de 1 000 fichiers, mais une modification du modèle suivie d’une nouvelle génération.
2. Définir un modèle XML cohérent
Le schéma XML doit refléter les besoins éditoriaux réels. Il peut prévoir des blocs réutilisables pour les caractéristiques, les tableaux de compatibilité, les consignes de sécurité ou les références croisées. Les règles doivent aussi gérer les cas où une information est absente, trop longue ou disponible dans plusieurs langues.
Une bonne pratique consiste à valider chaque fichier XML avant sa transformation. Le contrôle peut vérifier la présence d’un identifiant, la conformité d’une unité de mesure, la cohérence d’une date ou l’existence d’une image associée. Plus l’erreur est détectée tôt, moins sa correction coûte de temps.
3. Créer des gabarits de sortie
Le gabarit décrit la manière dont les données deviennent un document lisible. Il précise les niveaux de titre, les styles de paragraphe, les marges, les en-têtes, les pieds de page et les règles de saut de page. Il doit également prévoir les contenus longs, les tableaux qui débordent et les images de dimensions variables.
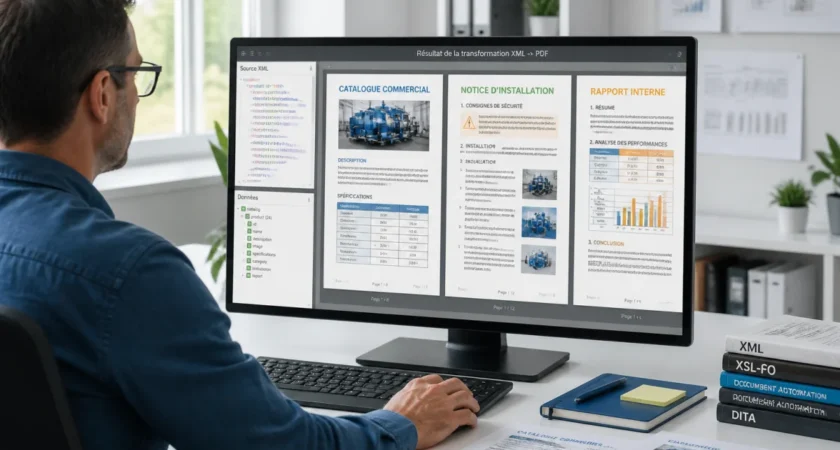
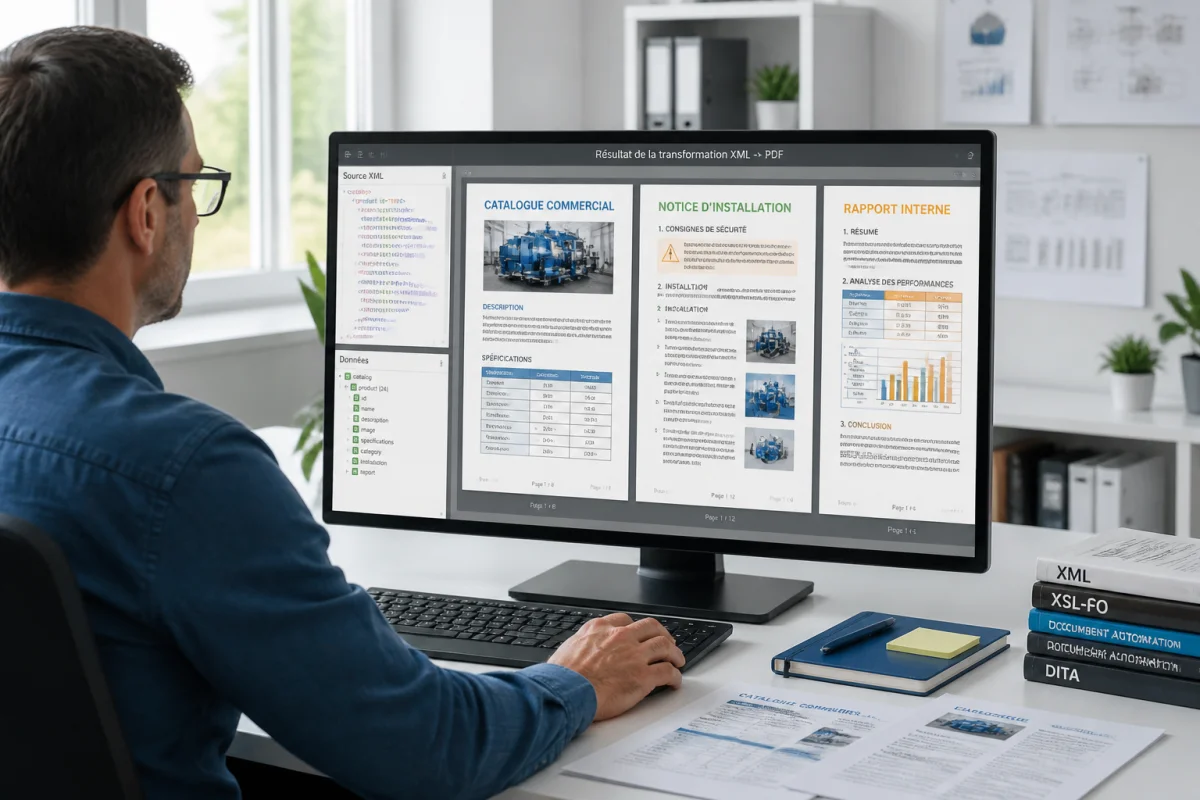
Une approche robuste prévoit plusieurs modèles plutôt qu’un gabarit unique surchargé. Un catalogue commercial, une notice d’installation et un rapport interne n’ont pas les mêmes contraintes de lecture. Les données peuvent rester communes, tandis que la présentation s’adapte au contexte.
Choisir les bonnes techniques de transformation
Le choix technique dépend du niveau de structure attendu et des outils déjà utilisés. Une transformation XSLT convient notamment lorsqu’un XML doit être converti vers une autre structure XML, du HTML ou un contenu intermédiaire. Pour des mises en page complexes destinées à l’impression, des moteurs spécialisés peuvent appliquer des règles de composition plus avancées.
Dans d’autres environnements, une API de génération PDF peut être intégrée à une application métier. Cette solution permet de déclencher la production lorsqu’une donnée est validée, lorsqu’une commande est créée ou lorsqu’une nouvelle version est publiée. Elle facilite aussi l’envoi automatique vers un espace documentaire, un outil de publication ou un système d’archivage.
Le choix ne doit pas se limiter à la qualité visuelle du PDF. Il faut aussi examiner la capacité à gérer les polices, les images, les signets, les métadonnées, l’accessibilité, les langues et les gros volumes. Un test sur un échantillon représentatif donne une vision plus juste qu’une démonstration réalisée sur un document court et parfaitement renseigné.
Contrôler la qualité avant la diffusion
La génération automatique ne dispense pas de contrôle. Elle permet surtout de remplacer une relecture dispersée par une série de vérifications mesurables et répétables. Le contrôle doit porter à la fois sur les données, la structure du document et son apparence finale.
Vérifier les données
Les contrôles de données peuvent repérer une référence manquante, une unité incohérente, une date invalide ou un champ qui dépasse une longueur définie. Ces règles sont particulièrement utiles lorsque plusieurs équipes alimentent la même source.
Vérifier le PDF
Le fichier produit doit être ouvert automatiquement pour vérifier sa présence, son nom, son poids et son nombre de pages. Des contrôles complémentaires peuvent rechercher un titre, un identifiant ou une mention obligatoire dans le texte extrait du PDF. Une comparaison visuelle de pages types permet aussi de repérer un tableau coupé ou une image mal positionnée.
Conserver une trace des versions
Chaque génération devrait être associée à une version des données, du gabarit et des règles de transformation. Cette traçabilité permet de comprendre pourquoi un document a été produit dans une forme donnée et de régénérer une édition précise si nécessaire. Elle devient précieuse lorsque plusieurs versions circulent en parallèle.
Les erreurs fréquentes qui ralentissent les projets
La première erreur consiste à commencer par le design du PDF sans clarifier les données. Un document peut être visuellement réussi tout en restant difficile à maintenir si ses informations sont mélangées dans des blocs de texte libres.
La deuxième consiste à reproduire dans le XML une mise en page trop rigide. Le XML doit décrire le sens et les relations entre les contenus, pas imposer chaque détail graphique. Les règles de présentation ont davantage leur place dans les gabarits.
La troisième est de ne tester qu’un cas idéal. Un jeu de test pertinent doit inclure un contenu très court, un contenu long, une image absente, un tableau volumineux, des caractères spéciaux et plusieurs langues si le projet le prévoit. Ces scénarios font ressortir les défauts avant la mise en production.
Enfin, il est risqué de laisser la validation entièrement à la fin. Des contrôles intermédiaires sur le XML et sur les données réduisent les corrections tardives. L’automatisation gagne ainsi en fiabilité sans ajouter une étape de vérification manuelle à chaque fichier.
Mesurer le gain obtenu
Le bénéfice ne se limite pas au temps de génération. Pour évaluer le projet, il est utile de comparer le temps consacré à la préparation, aux corrections, à la validation et à la diffusion avant et après automatisation. Le nombre d’erreurs détectées, le délai de mise à jour et le taux de documents produits sans reprise manuelle sont également de bons indicateurs.
À titre d’exemple, un processus qui demande quatre minutes par document pour une série de 500 fichiers représente plus de 33 heures de travail avant même les corrections. Si la nouvelle méthode réduit la préparation à une opération contrôlée sur les données et le modèle, le gain se répète à chaque nouvelle édition. La valeur se renforce encore lorsque le même contenu est décliné en PDF, en HTML et dans d’autres formats.
Ces mesures doivent être suivies sur plusieurs cycles de publication. Une première génération peut surtout servir à stabiliser les modèles, tandis que les éditions suivantes montrent le gain récurrent. Cette lecture évite de juger l’automatisation uniquement sur le temps de mise en place.
Une méthode immédiatement applicable
Pour démarrer, choisissez un périmètre limité mais représentatif, comme une série de fiches partageant la même structure. Documentez les champs sources, définissez les règles de validation, préparez un gabarit PDF et prévoyez un dossier de sortie clairement organisé. Faites ensuite tester le flux sur des contenus réels, y compris les cas qui sortent du modèle idéal.
Après cette première itération, séparez les corrections liées aux données de celles qui concernent la mise en page. Cette distinction permet de savoir si une amélioration doit être appliquée dans le XML, dans la source métier ou dans le gabarit. Elle évite aussi de retoucher un document final alors que la cause se trouve en amont.
Lorsque le processus est stable, ajoutez la génération à une chaîne de publication contrôlée. Un dépôt de versions, une validation automatique et un archivage des sorties suffisent souvent à rendre le flux plus lisible et plus sûr. Les équipes peuvent alors se concentrer sur la qualité du contenu plutôt que sur les tâches répétitives de copie et de mise en forme.
La qualité documentaire devient un processus
L’automatisation documentaire PDF et XML prend toute sa valeur lorsque le document n’est plus considéré comme un fichier isolé, mais comme la sortie d’un système maîtrisé. Des données structurées, des règles explicites, des gabarits réutilisables et des contrôles réguliers forment une chaîne cohérente, capable d’accompagner les mises à jour et les changements de volume.
Le meilleur point de départ reste un flux concret, mesurable et suffisamment représentatif des besoins quotidiens. En traitant d’abord la structure des contenus, puis la génération et enfin la diffusion, l’organisation obtient des documents plus cohérents et un temps de production mieux maîtrisé. Cette méthode prépare aussi l’édition multisupport, car une même information correctement structurée peut servir plusieurs usages sans être ressaisie.